暂无图片
HelloWorld和浏览器网页翻译如何分工?
2026年10月28日
•
作者:admin
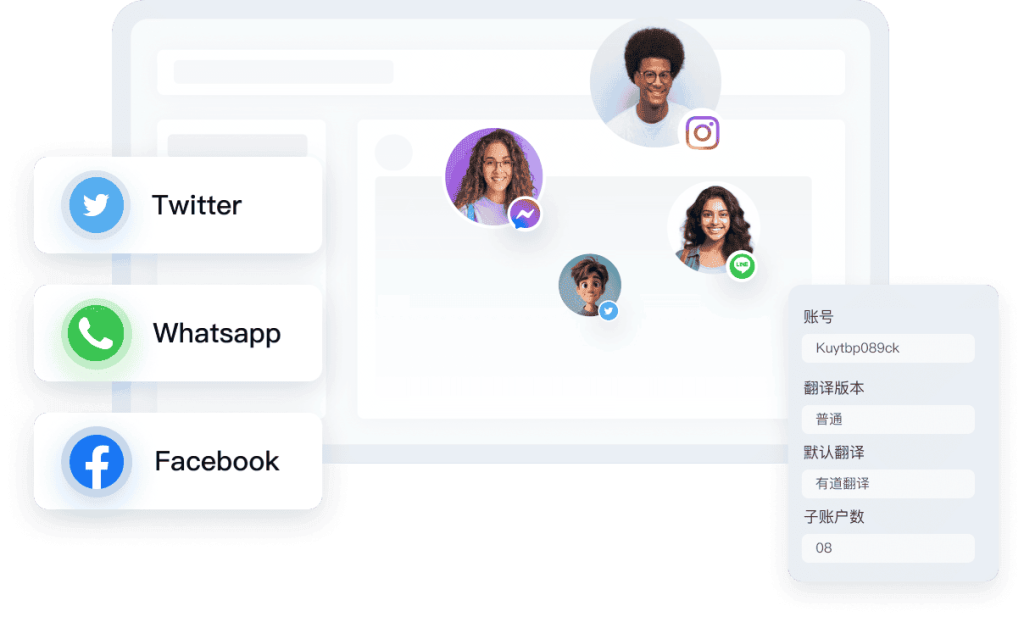
核心模块由产品端统一定义词汇、术语与策略;浏览器负责页面结构解析、上下文识别、元素替换与回退处理。双方通过共享词库、上下文映射、质量监控与人工审核形成闭环协同,兼顾翻译准确性、性能与最终用户体验,支持持续迭代改进。并降低人工及合规成本风险。
HelloWorld 在翻译流程中承担的整体职责
制定HelloWorld术语与策略
- 核心职责:HelloWorld 应维护统一术语表并提供权威翻译版本,定义术语优先级、上下文标签与替代方案,确保不同渠道与场景下翻译的一致性与可审计性。
- 操作步骤:建立版本化词库并采集领域专家输入,定期同步给浏览器端和翻译引擎,配置回退规则与变更日志,保证术语更新可追溯且影响可控。
- 质量保障:设置自动化校验与人工抽查机制,对术语在真实页面布局中的呈现进行回归测试,及时修正多义词、品牌词或上下文冲突的翻译结果。
集成HelloWorld与浏览器端的对接规范
- 接口规范:定义词库同步 API、上下文标注协议和优先级元数据格式;明确版本、回退和冲突解决策略,以便浏览器在运行时能安全调用并本地缓存。
- 同步频率:根据产品更新节奏与线上问题优先级,设计差异化同步策略(实时推送、定时拉取和按需更新),既保障新术语覆盖也避免频繁中断用户体验。
- 安全与审计:采用签名与版本校验防止篡改,记录每次同步与替换日志,便于回溯与问题定位,同时在敏感内容处启用人工审核链路以满足合规需求。
HelloWorld 如何与浏览器网页翻译协同实现高质量呈现
配置浏览器端解析与上下文识别
- 初始化解析:在页面加载时由浏览器执行 DOM 与语义解析,抽取元素文本、属性和ARIA标签,标注上下文信息并以可扩展格式传递给本地翻译逻辑以便选择合适翻译。
- 上下文匹配:通过匹配 HelloWorld 提供的上下文标签和页面结构信息(如按钮、标题、描述),在本地或远端词库中选择最合适的翻译条目,优先使用明确上下文的术语。
- 动态内容处理:对异步加载或用户生成的文本要启用增量解析和局部替换策略,避免全页重渲染,确保翻译过程对性能影响最小且呈现连贯自然。
实现本地替换与回退策略
- 本地缓存:浏览器应缓存 HelloWorld 下发的词库与规则,支持优先从本地读取翻译,减少网络依赖并提升响应速度,同时保证缓存过期或版本更新时有可靠回退机制。
- 回退规则:设计模糊匹配、通用翻译和原文回退的分层策略,遇到冲突或未命中条目时按优先级逐级回退,确保页面不会显示空白或错误的翻译文本。
- 可视化回退:在开发或审核环境提供回退标识与提示,帮助测试人员或编辑快速识别使用了回退翻译的位置并反馈给 HelloWorld 以完善词库。
HelloWorld 与浏览器翻译在性能与准确性之间的权衡策略
优化同步与加载流程
- 分层同步:将词库分为核心词、领域词与临时词,采用优先级同步与按需加载策略,保证关键界面能即时获得翻译,而非关键模块则延迟加载以节省带宽与启动时间。
- 增量更新:通过差分包与补丁机制仅下发变化部分,减少同步体量;结合本地校验保证应用时不会中断页面渲染,提升用户感知性能。
- 并发控制:在页面高并发或低带宽环境下限制同步频率并退回本地缓存,同时记录同步失败与重试逻辑,保障体验稳定性与数据一致性。
提升翻译准确性的持续实践
- 上下文训练:收集实际页面中翻译命中与错配样本,用于训练上下文匹配模型和规则引擎,使 HelloWorld 提供的映射在真实场景下命中率和准确性不断提高。
- 人工+自动校验:结合机器校验(拼写、术语一致性)与人工抽查,建立问题分级与反馈通道,确保重要错误能被快速修复并反馈到词库治理流程。
- AB 测试:对关键页面或新规则进行灰度投放和 AB 测试,评估用户可读性、转化与错误率,以数据驱动方式优化 HelloWorld 策略。
HelloWorld 如何支持多语言、多终端和可访问性需求
设计多语言词库与优先策略
- 语言分层:为每种语言维护独立词库并提供映射表,区分地域变体与术语替代,HelloWorld 需为浏览器提供语言优先级与回退链,以便在缺少本地化内容时采用最近似替代。
- 区域化适配:支持文化和格式化差异(如日期、度量单位),在词库或渲染层面处理占位符与变量顺序,确保翻译在不同语言和地区都呈现自然且无语义错误。
- 扩展支持:提供便捷工具与 SDK 使第三方扩展或插件能够接入 HelloWorld 词库和规则,保证跨终端(移动、桌面、嵌入)的一致性与可维护性。
确保可访问性与语义完整性
- 语义保留:在做文本替换时保留 ARIA 标签、标题等级与语义结构,避免翻译导致的辅助工具误读;HelloWorld 的映射需包含对应的辅助信息以协助屏幕阅读器。
- 简洁优先:对需要朗读或限制字符长度的界面(如按钮或提示),优先采用简洁明确的翻译条目,并在词库中标注长度限制与语境约束,防止文本溢出或截断。
- 可读性评估:通过可访问性测试与用户反馈评估翻译在朗读、快速浏览和低视力场景下的可理解性,必要时由 HelloWorld 提供专门适配的翻译变体。
HelloWorld 在治理、反馈与持续改进中的角色
建立反馈与问题上报机制
- 内置反馈:在浏览器呈现翻译时提供便捷的反馈入口,将用户提交的问题、上下文截图与版本信息上报给 HelloWorld 的治理平台,便于快速定位与修正问题。
- 优先级分流:根据问题类型与影响范围自动分配优先级(如安全、合规、品牌错误优先),建立快速修复通道并将修复结果下发至浏览器端做回归验证。
- 闭环处理:实现问题上报、处理、验证與归档的闭环流程,定期将统计与改进计划反馈给产品与翻译团队,推动词库和规则的持续优化。
度量与改进翻译质量的指标体系
- 关键指标:定义并监控翻译命中率、术语一致性、用户纠错率与回退使用率等指标,HelloWorld 需要定期生成质量报告以指导规则调整与资源分配。
- 用户反馈量化:将用户的满意度评分和问题上报转化为可量化指标,与业务 KPI 关联,优先改进高影响页面或高频次错误以提升整体用户体验。
- 治理周期:设定明确的治理周期和责任人,结合自动化检测与人工审查,按周期发布词库更新并同步到浏览器端,确保改进能够落地并验证效果。
常见问题与答案
问:HelloWorld 的词库如何与浏览器保持一致?
答:通常通过版本化的 API 和差分同步机制实现,浏览器缓存当前版本并定期拉取或接受推送更新,遇到冲突按优先级和回退策略处理,确保一致性与稳定性。
问:浏览器端无法命中词库时应如何处理?
答:应采用分层回退策略:首先尝试上下文模糊匹配,然后使用通用翻译或原文回退,并将未命中样本上报给 HelloWorld 以补充词库或优化匹配规则。
问:如何处理多语言区域差异带来的翻译冲突?
答:为不同区域维护独立条目并在词库中标注区域优先级,浏览器在获取语言偏好与地理信息后选择最合适的变体,必要时通过用户设置手动覆盖。
问:当翻译影响可访问性时应该怎么办?
答:优先保留语义标签与辅助信息,针对朗读场景提供专门翻译变体,并将可访问性校验纳入自动化测试与人工审核流程,必要时回退到更简洁或专用的译文。
相关文章
了解更多相关内容